

JavaScript SEO как обеспечить индексирование современного сайта

Содержание статьи:
- Что входит в JavaScript SEO
- Как поисковый робот обрабатывает страницу
- Почему видимая страница может не попасть в индекс
- CSR SSR статическая генерация и гидратация
- Как выбрать архитектуру рендеринга
- Требования к URL и внутренним ссылкам
- Метатеги canonical и структурированные данные
- Коды ответа ошибки и удаленные страницы
- Изображения пагинация и отложенная загрузка
- Как проверить доступность контента
- Техническое задание разработчику
- Распространенные ошибки
- Пошаговый план аудита
- Краткий вывод
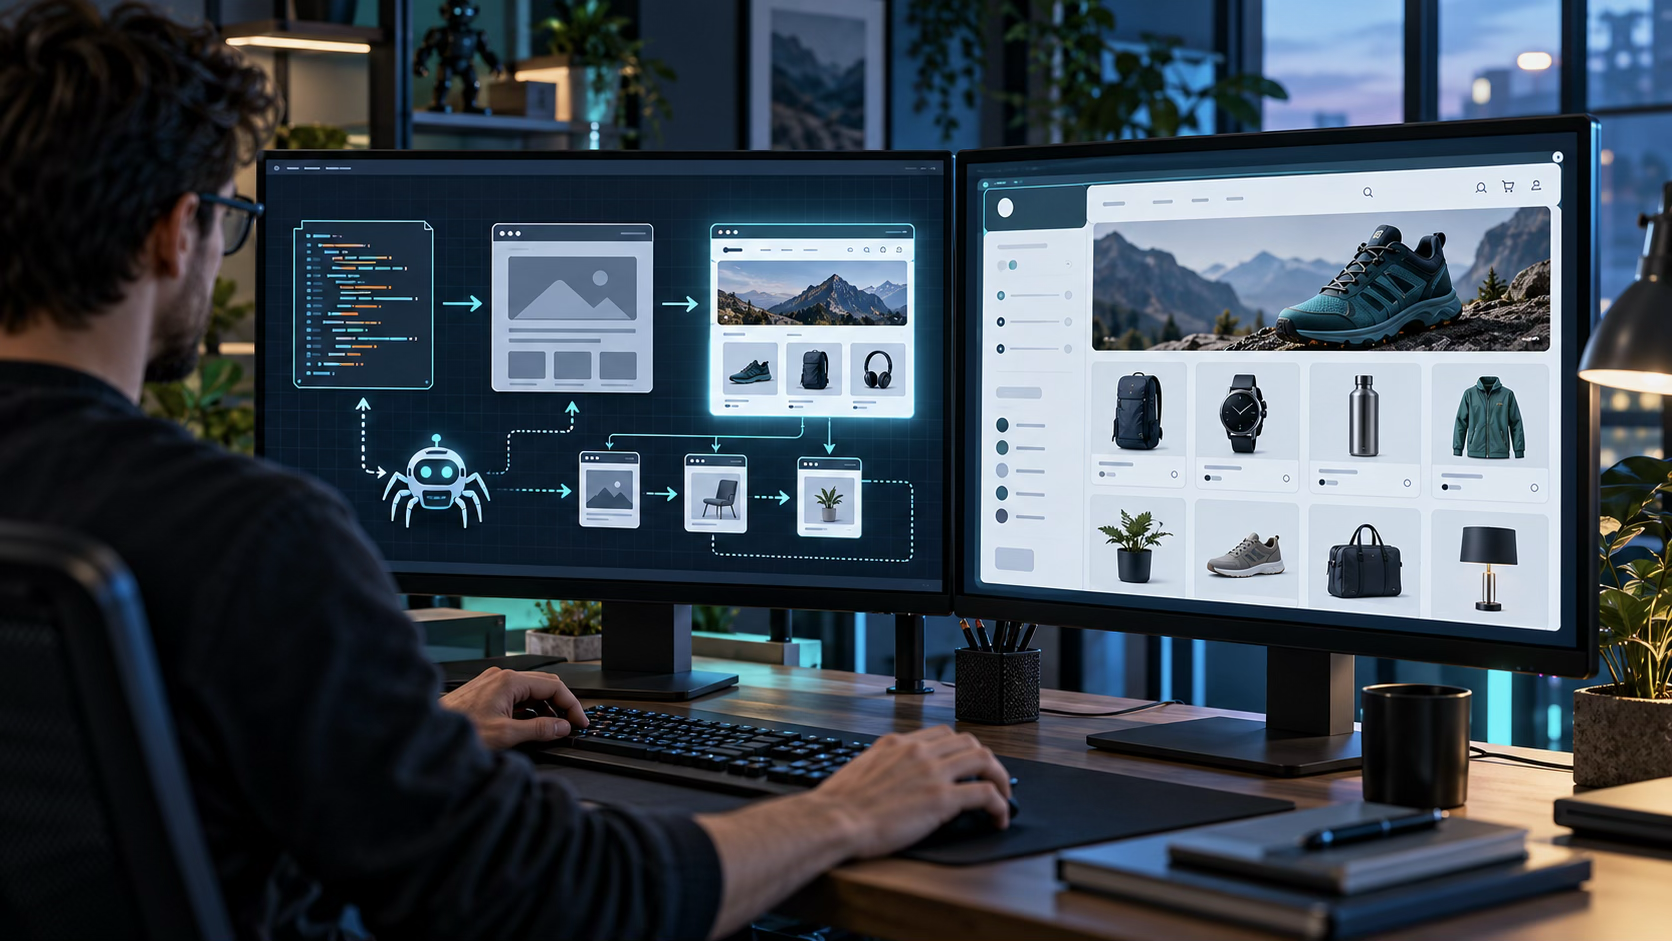 Интерфейс может безупречно работать у пользователя и при этом отдавать поисковому роботу пустой HTML, неправильный статус или ссылки, которые невозможно обнаружить. Такие ошибки возникают не из-за самого JavaScript и не из-за выбранного фреймворка. Их причина — в том, где формируется важный контент, как устроены URL и что сервер сообщает о странице. Ниже — практическая система проверки и исправления JavaScript-сайта с учетом задач бизнеса.
Что входит в JavaScript SEO
JavaScript SEO — часть технической оптимизации, которая обеспечивает обнаружение, рендеринг и индексирование публичных страниц, созданных с помощью JavaScript. В центре внимания находится не название технологии, а результат: робот должен получить корректный URL, содержимое, ссылки, метаданные и код ответа.
Фреймворки для построения интерфейсов сами по себе не создают и не устраняют SEO-проблемы. Один проект может отдавать полноценный HTML с сервера, другой — собирать весь экран только после загрузки кода и обращения к API. Внешне они выглядят одинаково, но для обхода и индексирования это разные архитектуры.
Бизнес сталкивается с последствиями, когда категории, товары или статьи поздно появляются в поиске, в индексе сохраняются удаленные страницы, поисковая система выбирает неправильный канонический адрес или не находит внутренние ссылки. Поэтому проверка JavaScript должна охватывать весь путь страницы, а не только то, что видно в браузере специалиста.
Как поисковый робот обрабатывает страницу
Обработка включает три связанные стадии: обход, рендеринг и индексирование. Сначала робот запрашивает URL, проверяет доступность и читает исходный ответ сервера. Уже на этом этапе он может извлечь обычные HTML-ссылки и принять решение на основе кода ответа, robots.txt и директив индексации.
Затем страница может попасть в очередь на рендеринг. Браузерный движок выполняет разрешенный JavaScript, обращается к доступным ресурсам и формирует итоговый DOM. После этого система повторно извлекает ссылки и оценивает отрендеренное содержимое для индексирования.
Очередь рендеринга означает дополнительный этап, но ее нельзя описывать фиксированной задержкой для всех сайтов. Время зависит от состояния URL, доступности ресурсов, сложности кода и возможностей поисковой системы. Практический вывод проще: важные коммерческие и информационные данные надежнее отдавать в первом HTML-ответе, не заставляя робота ждать клиентской сборки страницы.
Почему видимая страница может не попасть в индекс
Браузер пользователя выполняет код в полноценной сессии, хранит данные, может дождаться API и реагирует на клики. Робот работает иначе: он не обязан нажимать кнопки, прокручивать бесконечную ленту или проходить авторизацию. Если важный блок появляется только после действия, его доступность для индексирования становится ненадежной.
- Основной текст и H1 отсутствуют в исходном HTML и появляются только после успешного запроса к API.
- Файл сценария, стиль или адрес API закрыт правилами обхода либо возвращает ошибку.
- Код падает до формирования содержимого из-за несовместимой функции или непойманной ошибки.
- Карточки доступны только после прокрутки, фильтра или клика без самостоятельных URL.
- Навигация реализована кнопками и обработчиками, а обычных ссылок с href нет.
- Все состояния приложения отвечают кодом 200, включая несуществующие товары и ошибки.
Отдельный риск — несогласованность данных. Если исходный HTML содержит один заголовок или canonical, а клиентский код заменяет его другим, поисковая система получает противоречивые сигналы. Серверная и клиентская версии должны описывать одну и ту же страницу.
CSR SSR статическая генерация и гидратация
Клиентский рендеринг
При client-side rendering сервер обычно возвращает каркас приложения и ссылки на сценарии. Содержимое собирается в браузере. Подход уместен для личных кабинетов, внутренних систем и экранов, которым не нужен поисковый трафик. Для публичного каталога или блога он повышает зависимость от рендеринга и успешной работы API.
Чистый CSR не означает автоматического запрета на индексирование: крупные поисковые системы умеют выполнять JavaScript. Риск в другом — критичный контент, ссылки и метаданные становятся зависимыми от дополнительной очереди, ресурсов и выполнения кода.
Серверный рендеринг
При server-side rendering сервер формирует HTML для каждого запроса. Робот и пользователь сразу получают заголовки, текст, ссылки и основные данные страницы. После загрузки браузер может подключить интерактивность. Это снижает зависимость индексирования от клиентского выполнения, но требует контролировать скорость сервера, кеширование и совпадение серверной и клиентской разметки.
Статическая генерация
При статической генерации HTML создается заранее и обновляется при сборке или по заданному событию. Подход удобен для статей, справочных материалов, посадочных страниц и других разделов с предсказуемым обновлением. Для быстро меняющихся остатков и цен необходимо продумать частоту регенерации, иначе поисковик и пользователь увидят устаревшие данные.
Гидратация и гибридная модель
Гидратация добавляет интерактивность к уже полученному HTML. Гибридная архитектура позволяет выбирать режим на уровне маршрута или компонента: публичные страницы рендерить на сервере или генерировать заранее, а закрытые и высокоинтерактивные экраны собирать в браузере. Для большинства коммерческих проектов это практичнее, чем единый режим для всего приложения.
Динамический рендеринг, при котором ботам и пользователям отдают разные технические версии одного содержимого, допустим как обходной путь, но не как целевая архитектура. Он усложняет поддержку, может давать рассинхронизацию и требует постоянного контроля эквивалентности страниц.
Как выбрать архитектуру рендеринга
Выбор следует привязывать к типам страниц, а не к моде на конкретный стек.
- Категории, карточки, статьи и посадочные страницы должны отдавать основной контент, навигацию и метаданные без обязательного выполнения клиентского кода.
- Личный кабинет, редактор, калькулятор после входа и внутренний интерфейс могут оставаться клиентскими, если их не требуется индексировать.
- Редко меняющиеся страницы подходят для статической генерации; часто меняющиеся — для серверного или управляемого гибридного рендеринга.
- Если данные приходят из нескольких систем, нужно определить, что попадет в первый HTML и что можно безопасно догрузить позже.
Архитектурное решение оценивают по четырем критериям: полнота первого ответа, актуальность данных, скорость для пользователя и стоимость поддержки. Перенос всего сайта на серверный рендеринг не устранит неправильные URL, ошибки API или слабую внутреннюю перелинковку.
Требования к URL и внутренним ссылкам
Каждое индексируемое состояние должно иметь устойчивый URL, который открывается напрямую и возвращает ту же страницу после обновления. Маршруты вида обычного пути надежнее вариантов, где содержание меняется только после символа решетки. Фрагмент URL предназначен для перехода к части документа, а не для создания отдельных индексируемых страниц.
Ссылки на категории, товары, статьи и пагинацию оформляют элементом a с атрибутом href. Обработчик клика может перехватывать переход и сохранять поведение приложения, но адрес должен оставаться доступным в HTML. Кнопка с программным переходом не заменяет ссылку для обнаружения URL.
- Сервер должен уметь обрабатывать прямой запрос к любому публичному маршруту, а не возвращать ошибку вне главного экрана.
- Фильтры и сортировки требуют правил: какие комбинации индексируются, какие канонизируются, а какие закрываются от индекса.
- Бесконечная прокрутка должна иметь доступные URL порций или страниц, связанные обычными ссылками.
- Карта сайта дополняет внутреннюю навигацию, но не исправляет страницы без ссылочных связей и корректного ответа.
Метатеги canonical и структурированные данные
У каждого индексируемого URL нужны собственные title, description и заголовок страницы, соответствующие ее содержимому. Их можно формировать клиентским кодом, но надежнее включать критичные метаданные в первый HTML. Это уменьшает вероятность того, что робот увидит общий заголовок приложения или промежуточное состояние.
Canonical должен быть согласован между исходной и отрендеренной версиями. Нельзя сначала указать один адрес, а после выполнения JavaScript заменить его другим: такие противоречия затрудняют выбор основной страницы. Если канонический адрес вычисляется динамически, логика должна быть единой на сервере и клиенте.
Структурированные данные должны описывать видимое пользователю содержимое. Их также стоит отдавать в исходном HTML и проверять после рендеринга. Само наличие JSON-LD не помогает, если товар, цена или статья отсутствуют на странице либо расходятся с данными в разметке.
Коды ответа ошибки и удаленные страницы
Одностраничное приложение часто возвращает оболочку с кодом 200 для любого пути. В результате несуществующий товар визуально показывает сообщение об ошибке, но сервер сообщает поисковику, что документ найден. Так возникают мягкие ошибки 404 и лишние URL в обходе.
- Существующая страница должна отвечать успешным кодом и содержать заявленные данные.
- Удаленный без замены URL должен возвращать 404 или 410.
- При постоянном переносе используется серверное перенаправление на релевантный новый адрес.
- Закрытый раздел сообщает об авторизации и не маскируется под общедоступную страницу.
- Сбой API не должен превращаться в индексируемую пустую карточку с кодом 200.
Если архитектура не позволяет сразу вернуть правильный статус, необходимо хотя бы исключить ошибочное состояние из индекса и направить робота на URL, где сервер отдает корректный ответ. Целевое решение все равно должно находиться на уровне маршрутизации и сервера.
Изображения пагинация и отложенная загрузка
Отложенная загрузка полезна для скорости, но не должна зависеть только от нестандартного пользовательского действия. Используйте нативные механизмы и убедитесь, что адрес изображения присутствует в доступной разметке. Главное изображение первого экрана обычно загружают приоритетно, а не откладывают до прокрутки.
Для каталогов критична пагинация. Поисковый робот должен иметь возможность последовательно обнаружить страницы и карточки через ссылки. Бесконечная лента может оставаться удобным интерфейсом, если под ней существует адресуемая структура, доступная без прокрутки и выполнения сложного сценария.
Фильтры не следует автоматически превращать в тысячи индексируемых комбинаций. Сначала определяют страницы, которые соответствуют самостоятельному спросу, затем формируют для них постоянные URL, уникальные метаданные, контент и внутренние ссылки. Остальные состояния остаются пользовательскими инструментами без претензии на отдельную видимость.
Как проверить доступность контента
Проверка должна сравнивать несколько представлений страницы, потому что каждый слой отвечает на отдельный вопрос.
1. Запросите URL без выполнения JavaScript и проверьте код ответа, title, canonical, H1, основной текст, ссылки и структурированные данные.
2. Откройте отрендеренный DOM и убедитесь, что после работы приложения данные не исчезли, не задвоились и не изменили смысл.
3. Проверьте страницу инструментом проверки URL поисковой системы и изучите полученный HTML и снимок.
4. Просмотрите сетевые ошибки, заблокированные ресурсы, ответы API и сообщения консоли.
5. Откройте внутренние маршруты напрямую, обновите страницу и проверьте возврат назад и вперед.
6. Пройдите сайт краулером сначала без выполнения JavaScript, затем с рендерингом и сравните найденные URL и элементы.
7. Проанализируйте серверные журналы: какие URL посещают роботы, какие статусы получают и где повторяются ошибки.
Тест с отключенным JavaScript полезен как диагностика первого HTML, но не является универсальным требованием к пользовательскому интерфейсу. Важно не то, чтобы весь функционал работал без сценариев, а чтобы публичный контент и путь обнаружения страниц не зависели от хрупкой клиентской цепочки.
Техническое задание разработчику
Формулировка «сделать сайт индексируемым» слишком расплывчата. Задача должна содержать проверяемый результат.
- Перечень шаблонов и URL, на которых проявляется проблема.
- Сравнение исходного и отрендеренного HTML с отсутствующими элементами.
- Ожидаемый код ответа и поведение для существующего, удаленного и перенесенного адреса.
- Правило формирования title, canonical, robots и структурированных данных.
- Требование к ссылкам, пагинации и прямому открытию маршрута.
- Критерий приемки: что должно присутствовать в первом ответе и что подтверждается после рендеринга.
После исправления проверяют не только отдельный URL, но и шаблон в разных состояниях: товар в наличии и без остатка, категория с несколькими страницами, удаленный объект, фильтр, мобильная версия и ошибка API.
Распространенные ошибки
- Считать, что поисковик гарантированно выполнит любой JavaScript так же, как браузер пользователя.
- Объявлять весь клиентский рендеринг неиндексируемым и начинать дорогостоящий перенос без диагностики.
- Проверять только визуальный интерфейс и не смотреть исходный ответ сервера.
- Использовать кнопки вместо ссылок на индексируемые страницы.
- Возвращать 200 для ошибок, удаленных карточек и неизвестных маршрутов.
- Менять canonical после загрузки на значение, противоречащее исходному HTML.
- Закрывать файлы сценариев или API, необходимые для формирования публичного содержимого.
- Отдавать роботам и пользователям разные по смыслу страницы под видом оптимизации.
- Внедрять серверный рендеринг, но оставлять медленный ответ, ошибки гидратации и двойные запросы данных.
- Проверять только главную страницу, хотя проблема находится в каталоге, пагинации или карточках.
Пошаговый план аудита
1. Составьте список публичных шаблонов, которые должны получать поисковый трафик.
2. Для каждого шаблона сравните исходный HTML, отрендеренный DOM и данные проверки URL.
3. Зафиксируйте отсутствующий контент, ссылки, метатеги, structured data и неправильные статусы.
4. Проверьте маршруты, прямое открытие URL, пагинацию, фильтры и обработку ошибок.
5. Разделите проблемы по уровню: сервер, приложение, API, шаблон, внешнее подключение.
6. Выберите режим рендеринга для каждого типа страниц с учетом актуальности данных и стоимости поддержки.
7. Сформулируйте задачи с измеримыми критериями приемки и тестовыми URL.
8. После выпуска повторите обход без JavaScript и с рендерингом, затем запросите переобход при необходимости.
9. Настройте регулярную проверку шаблонов и отслеживайте статусы роботов по журналам сервера.
Краткий вывод
JavaScript не мешает продвижению сам по себе. Проблемы начинаются, когда публичная страница существует только после выполнения клиентского кода, важные URL невозможно обнаружить по ссылкам, метаданные противоречат друг другу, а сервер отвечает успешным кодом на ошибки.
Надежная архитектура отдает критичный контент и сигналы в первом HTML, сохраняет обычные адресуемые ссылки, корректно обрабатывает статусы и использует JavaScript для интерактивности, а не как единственный способ существования страницы. Режим рендеринга выбирают по типу раздела: публичным коммерческим и информационным страницам нужна максимальная доступность, закрытым приложениям — удобство работы. Результат подтверждают сравнением исходной и отрендеренной версии, проверкой URL и анализом реального обхода.
Технические рекомендации сверены с актуальной документацией Google Search Central по JavaScript SEO.